04nov
sreda, 04. novembra, 2026
sreda, 04. novembra, 2026
AIChatGPT si zapomni več, kot si mislite
Kaj si ChatGPT zapomni o svojih uporabnikih, kako uporablja te informacije in koliko nadzora imamo nad tem, kaj o nas ve?

Alenka Paulin Kerševan
Kaj si ChatGPT zapomni o svojih uporabnikih, kako uporablja te informacije in koliko nadzora imamo nad tem, kaj o nas ve?
04. november 2026.
 Dodajte MM kot priljubljen vir v Googlu
Na LinkedInu smo zasledili zapis Alenke Paulin Kerševan, ustanoviteljice podjetja Feldmar Media, v katerem predstavlja ugotovitve raziskave The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT. Ta razkriva, katere informacije si ChatGPT zapomni o svojih uporabnikih, kako nastajajo spominski zapisi in kaj to pomeni za njihovo zasebnost. Njen zapis v nadaljevanju objavljaMMo v celoti.
Lastniki velikih sistemov generativne umetne inteligence zdaj ne zbirajo samo tega, kaj klikamo in delimo. Iz naših zasebnih pogovorov gradijo psihološke profile, ki vključujejo strahove, želje, namere, prepričanja in čustva. Raziskava The Algorithmic Self-Portrait je pokazala, da je približno 96 odstotkov analiziranih spominskih zapisov ChatGPT ustvaril sam, brez izrecne uporabnikove prošnje za shranjevanje. Psihološke informacije je vsebovalo 52 odstotkov zapisov, med shranjenimi podatki pa so bile tudi informacije o zdravju. Podoba, ki jo umetna inteligenca o nas sestavi, omogoča izjemno personalizacijo in hkrati odpira pot odvisnosti ter subtilni manipulaciji odločitev.
Spomin pogovornih sistemov omogoča ohranjanje informacij med pogovori in prilagajanje odgovorov posameznemu uporabniku. Raziskava The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT ta mehanizem obravnava kot nastajanje »algoritemskega avtoportreta«, s čemer avtorji opisujejo podobo uporabnika, ki temelji na informacijah, razkritih v zasebnih pogovorih, njeno oblikovanje in dopolnjevanje pa usmerjajo algoritmi sistema.
Raziskovalci so si zastavili štiri osrednja vprašanja: kdo ima večjo vlogo pri posodabljanju spomina, katere informacije sistem shranjuje, kako zvesto zapisi odražajo uporabnikove pogovore in ali je mogoče nastajanje spomina posnemati za zmanjševanje tveganj za zasebnost. Skupaj so zajeli 2.050 vnosov iz 1.058 pogovorov.
Podatki so izvirali iz zbirke InVivoGPT. Sodelujoči so bili pridobljeni prek platforme Prolific. Za vključitev so morali imeti najmanj sto pogovorov in vsaj 90 dni aktivne uporabe. Raziskovalci so shranjevanje prepoznavali po zapisih orodja »bio« in jih povezovali s sporočili, ki so sprožila posodobitev spomina.
Prva skupina ugotovitev se nanaša na odločanje o shranjevanju. Samo 84 vnosov oziroma približno 4,1 odstotka je bilo povezanih z zaznano izrecno uporabnikovo zahtevo za operacijo s spominom. Preostalih približno 96 odstotkov je sprožil sistem. Avtorji zato ugotavljajo, da oblikovanje spomina pretežno usmerjajo sistemski mehanizmi za samodejno shranjevanje informacij, ocenjenih kot uporabnih za prihodnje pogovore.
Druga skupina ugotovitev zadeva osebne podatke. Po razvrstitvi, uporabljeni v raziskavi, jih je vsebovalo 28 odstotkov spominskih vnosov. Posebne vrste osebnih podatkov, med katere sodijo tudi zdravstveni podatki, so prepoznali v 7 odstotkih vnosov. Na ravni uporabnikov s prepoznanimi spominskimi zapisi je imelo osebne podatke v spominu 91 odstotkov sodelujočih, posebne vrste osebnih podatkov pa 54 odstotkov. Zdravstvene informacije so našli pri 35 odstotkih teh uporabnikov.
Raziskava uporablja tudi razvrstitev psiholoških vsebin. Avtorji pojasnjujejo, da spominski zapisi lahko hkrati zajamejo identiteto človeka in njegovo subjektivno doživljanje. Informacija o strahu pred neuspehom pri kariernih odločitvah tako vsebuje drugačno vrsto vsebine kot podatek o imenu ali poklicu. Za obravnavo takšnih zapisov so uporabili okvir teorije uma, ki vključuje predstavljanje in sklepanje o duševnih stanjih drugih.
Najmanj eno psihološko kategorijo so prepoznali v 52 odstotkih vseh analiziranih vnosov. Takšne vsebine so bile prisotne pri 97 odstotkih uporabnikov s spominskimi zapisi. Med vnosi s psihološko vsebino so bile najpogostejše želje, preference in cilji, ki so se pojavili v 73 odstotkih. Namere so bile prisotne v 16 odstotkih, čustva v 14 odstotkih in prepričanja v 11 odstotkih. Znanje in zaznave so prepoznali vsako v 7 odstotkih, razumevanje nedobesednega sporazumevanja pa v 2 odstotkih.
Avtorji ugotavljajo, da spomin pogosteje ohranja informacije o trajnejših ciljih, željah in namerah kot o prehodnih občutjih. To povezujejo z namenom vzdrževanja vsebinsko povezanih odnosov skozi daljše obdobje uporabe. Nastajajoči avtoportret tako opisujejo predvsem skozi uporabnikove cilje in motivacijske značilnosti, ne zgolj skozi demografske podatke ali trenutna čustvena stanja.
Tretji del raziskave preverja, kako so spominski zapisi povezani s tem, kar je uporabnik dejansko povedal. Raziskovalci so razlikovali med dobesednim prekrivanjem, pomensko podobnostjo in presojo, ali zapis logično izhaja iz razpoložljivega konteksta.
Pri dobesednem prekrivanju so ob upoštevanju najširšega konteksta poročali o približno 84-odstotni vrednosti. Gre za merilo prekrivanja besedila spomina z uporabnikovim kontekstom. Ločena presoja z jezikovnim modelom je 77 odstotkov zapisov uvrstila med neposredno povedane ali povzete informacije, 14 odstotkov med logične sklepe, pet odstotkov med šibko podprte zapise in štiri odstotke med nepodprte.
Razliko med povzemanjem in sklepanjem raziskava ponazori s konkretnimi primeri. Prošnja za predloge poceni obrokov za več energije je vodila v zapis, da želi uporabnik s prilagoditvijo prehrane izboljšati svojo raven energije. Tak zapis so obravnavali kot logično sklepanje.
Pri prošnji za glasbene skupine, podobne Nirvani, pa je nastal zapis, da ima uporabnik rad Nirvano. Ta sklep je bil ocenjen kot šibko podprt, saj zanimanje za priporočilo samo po sebi ne potrjuje glasbene preference.
Četrti del raziskave se ukvarja s posnemanjem nastajanja spomina. Raziskovalci so preizkusili odprte modele, ki so iz vprašanja in predhodnega konteksta napovedovali možen spominski zapis. Ustvarjeni zapisi so dosegali pomensko podobnost z dejanskimi zapisi ChatGPT.
V dodatnem poskusu so preverili, koliko informacij bi bilo mogoče izluščiti, če bi nastajanje spomina razširili tudi na vprašanja, pri katerih izvirni sistem ni ustvaril vnosa. Takšno razširjeno izluščanje je prineslo dodatne osebne in psihološke informacije.
Na tej podlagi so predstavili eksperimentalni pristop Attribution Shield, v prevodu »ščit pred pripisovanjem«, ki v tem primeru pomeni zaščito pred pripisovanjem osebnih informacij uporabniku. Gre za zmanjševanje možnosti, da sistem vsebino vprašanja razume kot podatek o uporabniku. Njegov namen je uporabnika opozoriti na potencialno občutljive informacije, ki bi jih bilo mogoče izluščiti iz vprašanja, ter predlagati preoblikovanje z manj neposrednega osebnega pripisovanja. Osebno izražena prošnja se tako lahko spremeni v splošnejše vprašanje o isti temi.
Pri preizkusu približno 36 vprašanj je avtomatizirana presoja pri 94,4 do 100 odstotkih preoblikovanj ugotovila zmanjšano pripisovanje informacij uporabniku. Človeška presoja je ohranjeno uporabnost prepoznala pri 87 do 91 odstotkih preoblikovanih vprašanj, kar nakazuje, da bi bil tak pristop lahko uporaben način zmanjševanja osebnega pripisovanja ob ohranjanju namena poizvedbe.
ChatGPT-jev spomin torej nastaja z veliko algoritmične samostojnosti ter vključuje osebne podatke in informacije o uporabnikovih psiholoških značilnostih, kar lahko vodi v pripisovanje občutljivih informacij. Za uporabnike te ugotovitve pomenijo, da lahko osebna informacija iz posameznega pogovora postane del spomina, namenjenega prilagajanju prihodnjih odgovorov, tudi če njenega shranjevanja niso izrecno zahtevali. Podoba, ki jo sistem ohranja o uporabniku, namreč vključuje tudi njegovo doživljanje in načrte, zato sta pravilnost shranjenih informacij in uporabnikov nadzor nad nastajanjem spomina še toliko pomembnejša.
Prav pri ChatGPT previdnost ni odveč, saj ima med večjimi pogovornimi sistemi trenutno najbolj »agentičen« spomin – sistem sam odloča, kaj se shrani, in to počne v veliki večini primerov. Claude je bolj restriktiven do občutljivih tem in daje uporabniku več nadzora nad posameznimi spomini. Gemini je bolj povezan z Googlovim ekosistemom, zato lahko profil postane širši, ima pa ločene kontrole za zgodovino pogovorov in eksplicitno shranjene informacije.
Uporabnik lahko osebno informacijo (vključno s cilji, željami ali zdravstvenimi podatki) nehote »pripiše« sebi že z navadnim vprašanjem, tudi če nikoli ne reče »zapomni si«. Ko enkrat postane del spomina, lahko vpliva na prihodnje odgovore. Zato je smiselno občasno pregledati seznam spominov in izbrisati tiste, ki niso želeni, ali funkcijo začasno izklopiti, kadar gre za občutljive teme.
Raziskovalci so preizkusili tudi preprost pristop, pri katerem se potencialno občutljiva informacija oziroma vprašanje preoblikuje v bolj splošno obliko. Pri večini preoblikovanih vprašanj se je osebno pripisovanje zmanjšalo, uporabnost odgovora pa je ostala visoka. To nakazuje, da je tehnično mogoče zmanjšati tveganje, ne da bi bistveno poslabšali izkušnjo.
Za dostop do vseh člankov vas vabimo, da se brezplačno registrirate.
Registriraj seSte že registrirani? Prijavite se tukaj
04nov
sreda, 04. novembra, 2026
sreda, 04. novembra, 2026
AIKaj si ChatGPT zapomni o svojih uporabnikih, kako uporablja te informacije in koliko nadzora imamo nad tem, kaj o nas ve?
04nov
sreda, 04. novembra, 2026
sreda, 04. novembra, 2026
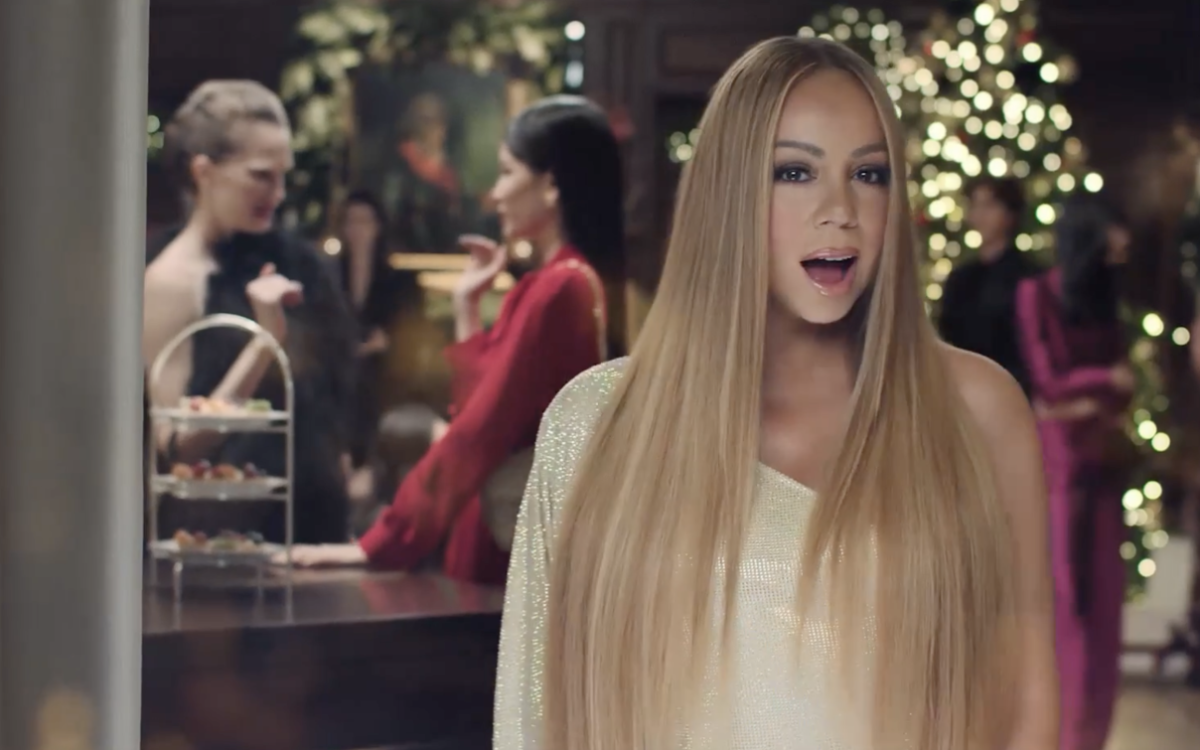
Tuji oglasiSpletna šala o vsakoletnem »odtajanju« Mariah Carey se nadaljuje. Pevka je 1. novembra naznanila začetek božične sezone, že naslednji dan pa jo je Gucci predstavil v praznični kampanji »Gucci Gift«.
04nov
sreda, 04. novembra, 2026
sreda, 04. novembra, 2026
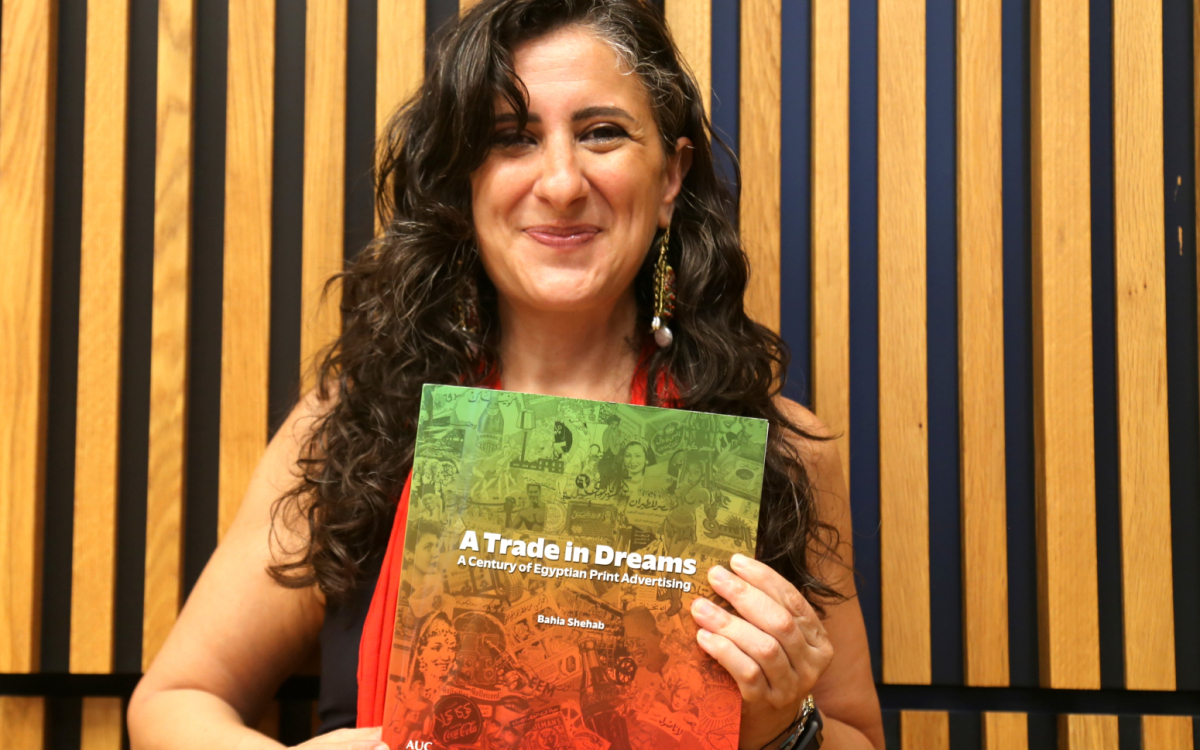
MMarketingBahia Shehab je poleti v Svetovnem muzeju na Dunaju predstavila svojo najnovejšo knjigo A Trade in Dreams: A Century of the Egyptian Print Advertising, prvo knjigo o oglaševanju v Egiptu.
04nov
sreda, 04. novembra, 2026
sreda, 04. novembra, 2026
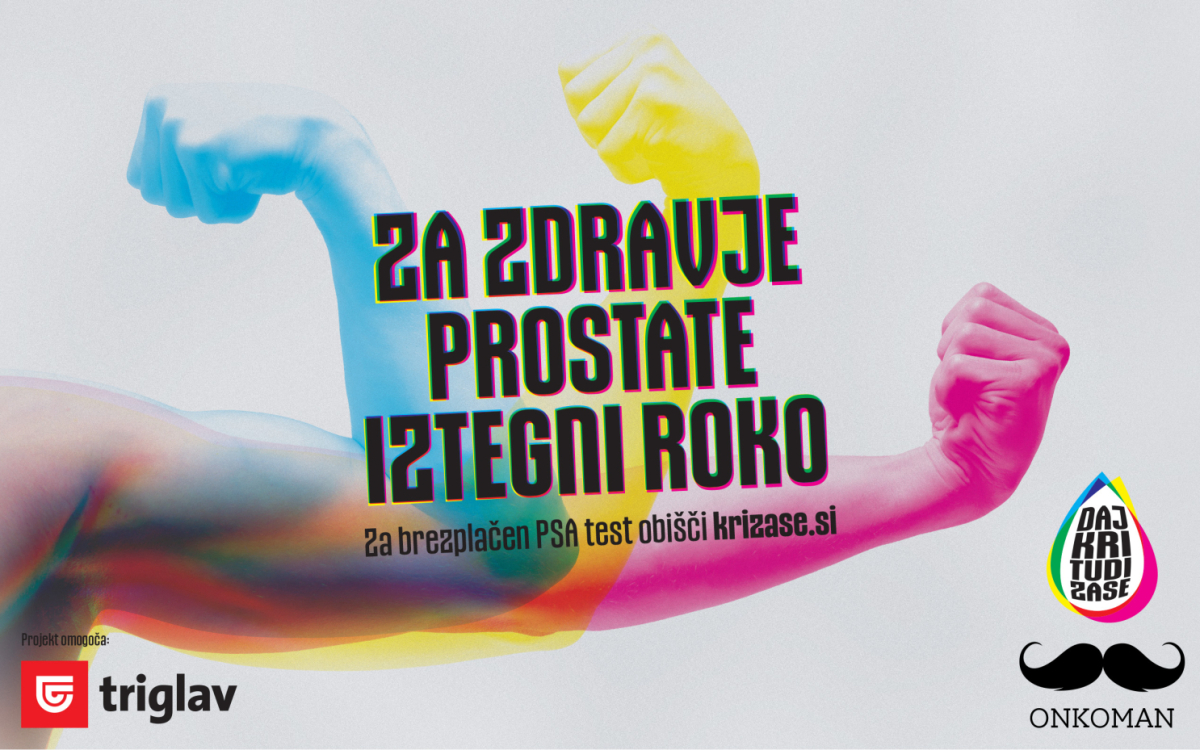
Opazili smoDruštvo OnkoMan, Zavarovalnica Triglav in agencija Futura DDB s pobudo »Daj kri tudi zase« nagovarjajo moške, ki nesebično darujejo kri za druge, pregled za lastno zdravje pa odlagajo.
16okt
petek, 16. oktobra, 2026
petek, 16. oktobra, 2026
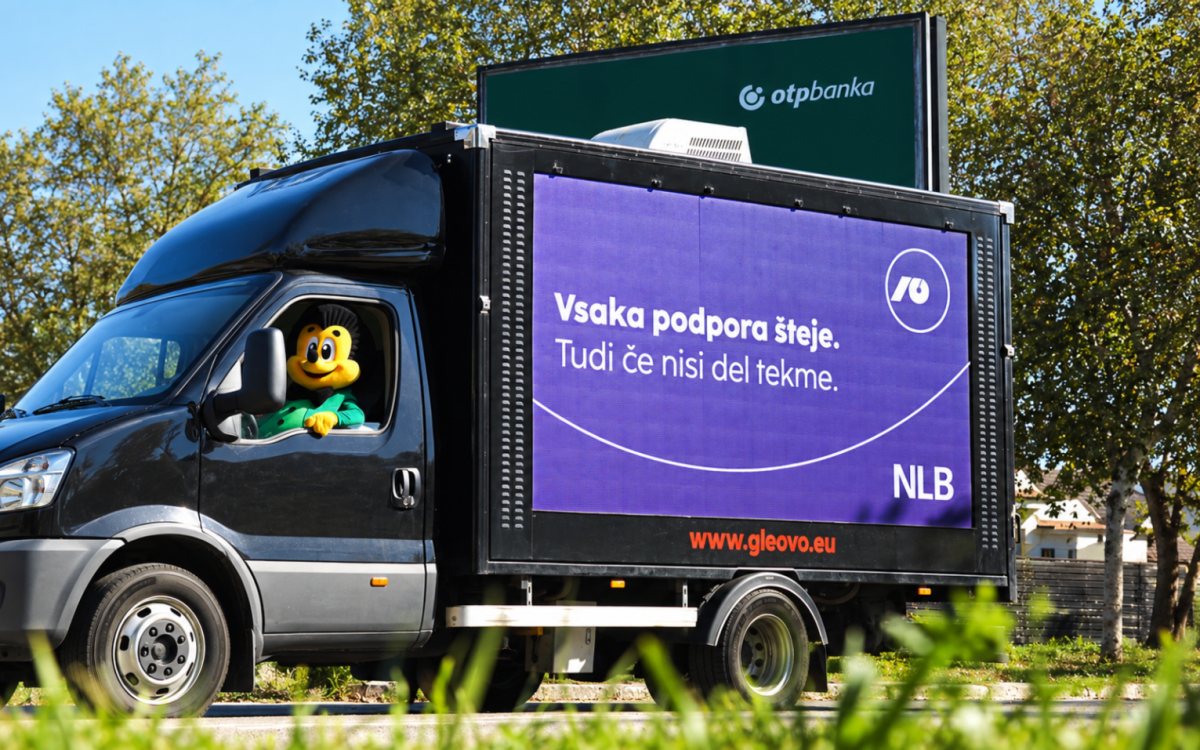
MMarketingOb selitvi sedeža OTP banke v Ljubljano je NLB konkurenco pričakal z bankomatom, ki je delil sporočila dobrodošlice. Dve leti pozneje pa je oglaševalski dvoboj pred Ljubljanskim maratonom začel OTP.
16okt
petek, 16. oktobra, 2026
petek, 16. oktobra, 2026
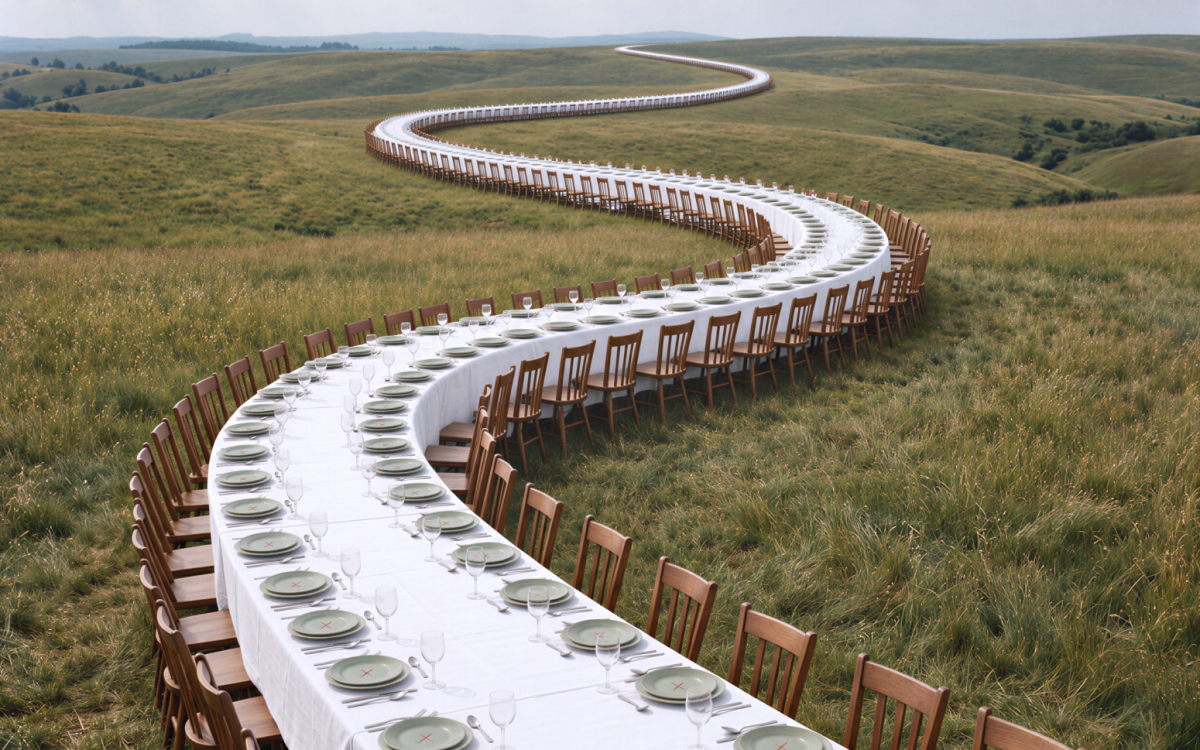
OzaveščaMMoPri Jezeršek gostinstvu odgovornosti niso začeli graditi zato, ker je trajnost postala dobra marketinška zgodba.
12okt
ponedeljek, 12. oktobra, 2026
ponedeljek, 12. oktobra, 2026
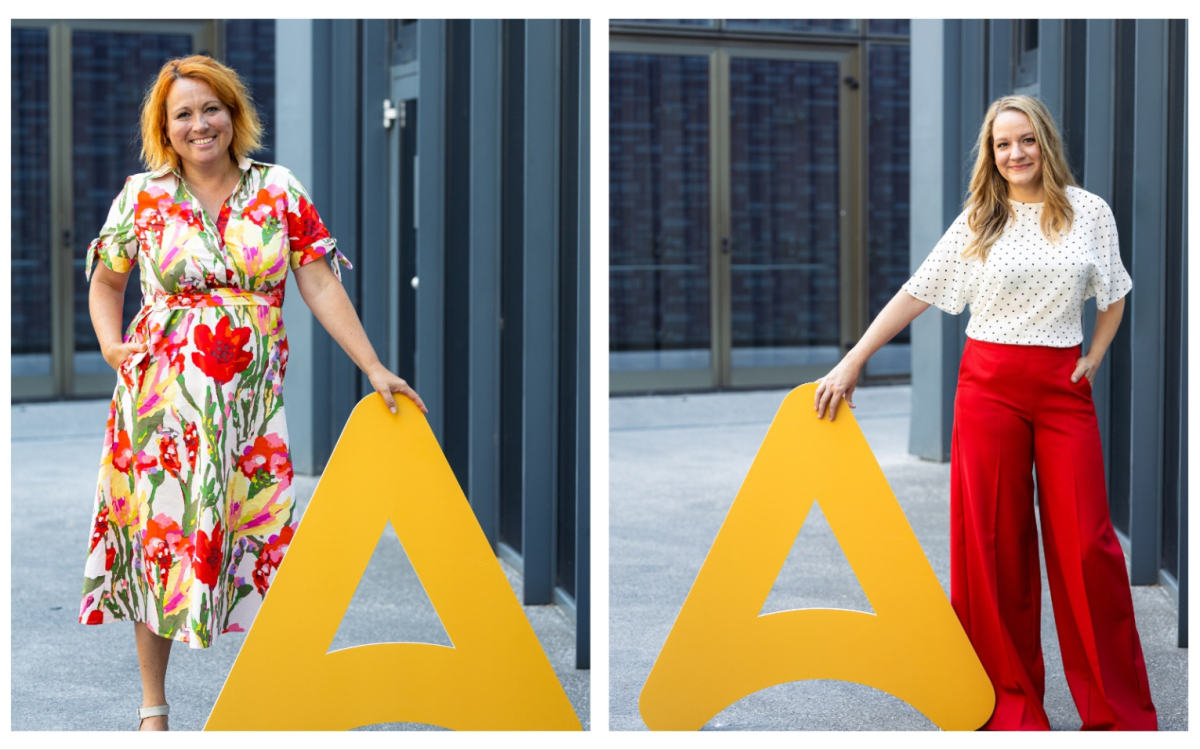
AktualnoV rubriki Življenje z znaMMkami tokrat gostimo Marušo Komac, vodjo marketinga v Nomagu, in Andrejo Keš, direktorico agencije Bid Bid.
15okt
četrtek, 15. oktobra, 2026
četrtek, 15. oktobra, 2026
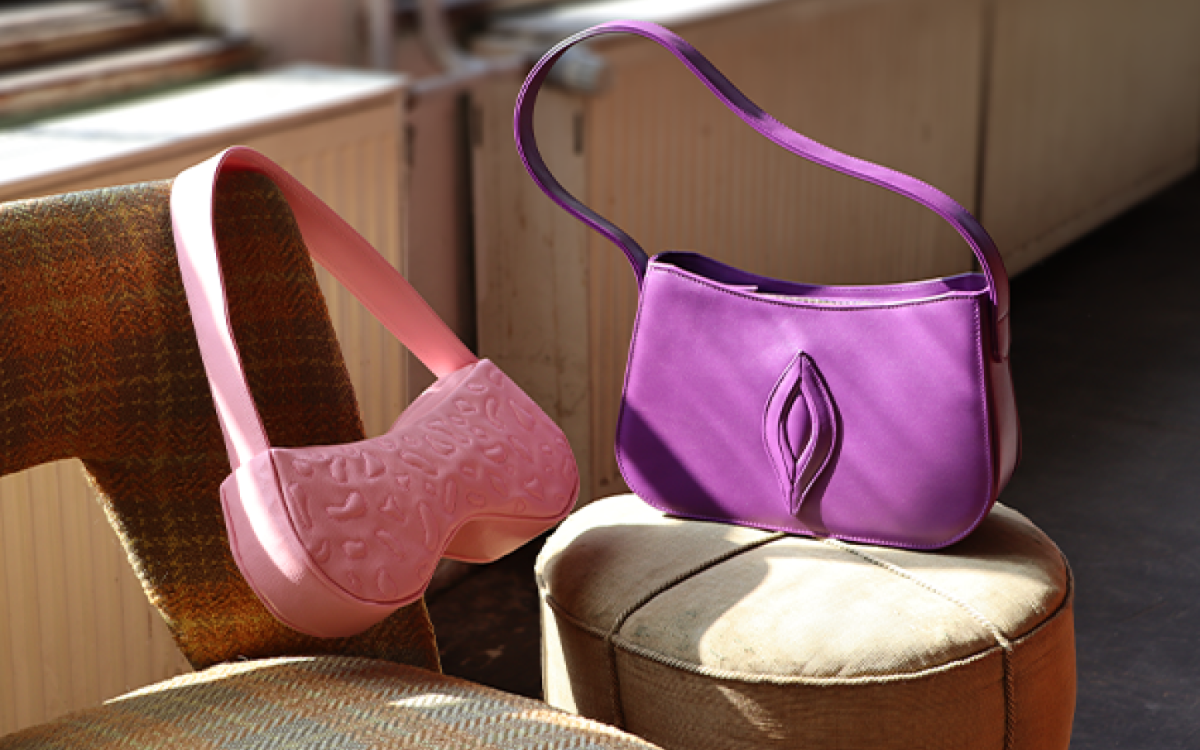
Novi oglasiZdruženje Europa Donna Slovenija je v sklopu letošnje kampanje ozaveščanja o raku dojk in rakih rodil predstavila tri unikatne torbice, ki so jih oblikovale Maja Šebenik, Živa Ferlež in Maja Ferme.
08okt
četrtek, 08. oktobra, 2026
četrtek, 08. oktobra, 2026
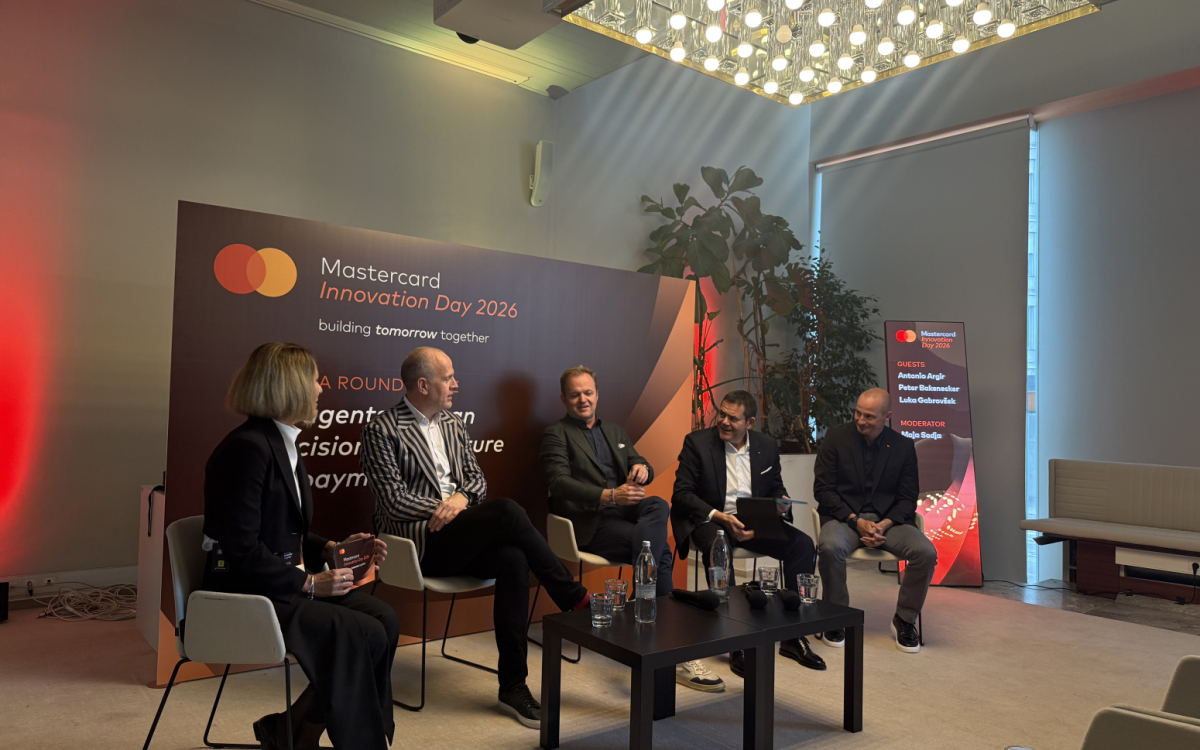
AIAgenti UI bodo vse pogosteje odločali, kaj kupujemo. Na dogodku Mastercard Innovation Day v Ljubljani so razpravljali, kaj to pomeni za trgovce, blagovne znamke in prihodnost plačevanja.
05okt
ponedeljek, 05. oktobra, 2026
ponedeljek, 05. oktobra, 2026
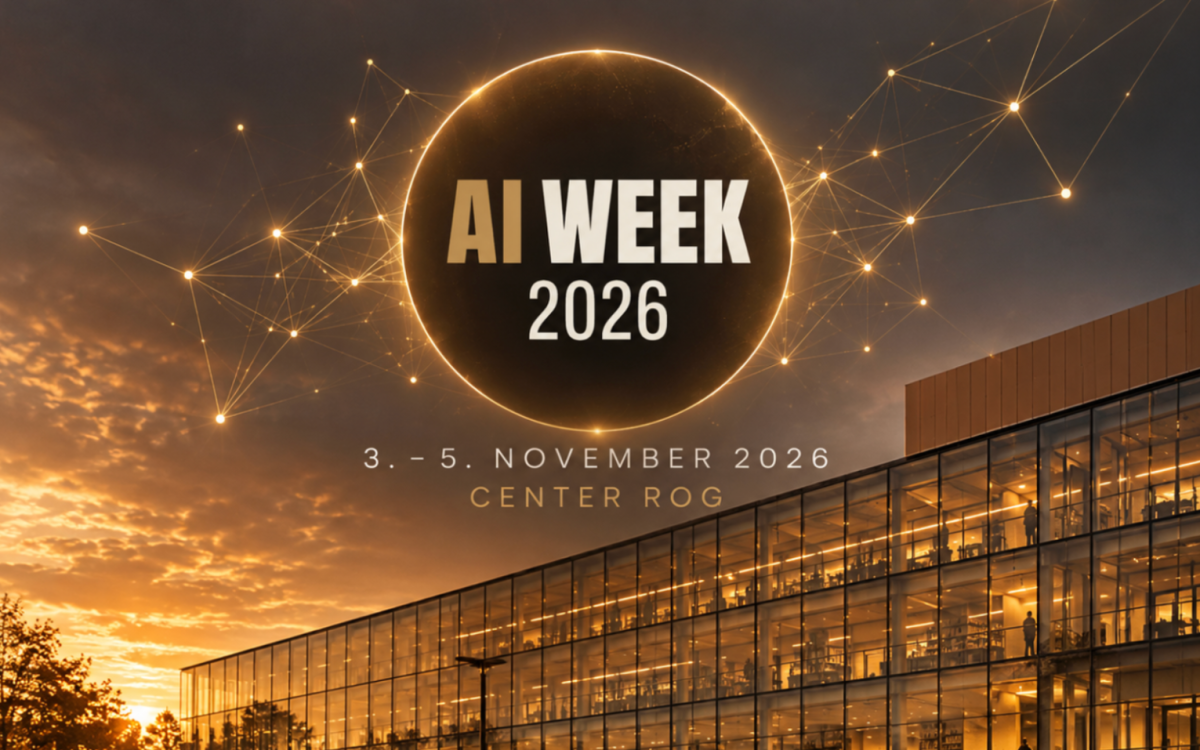
AIMed 3. in 5. novembrom bo v Ljubljani prvič potekal AI WEEK, tridnevni dogodek o vplivu umetne inteligence na družbo, poslovanje in vsakdanje življenje.
05okt
ponedeljek, 05. oktobra, 2026
ponedeljek, 05. oktobra, 2026
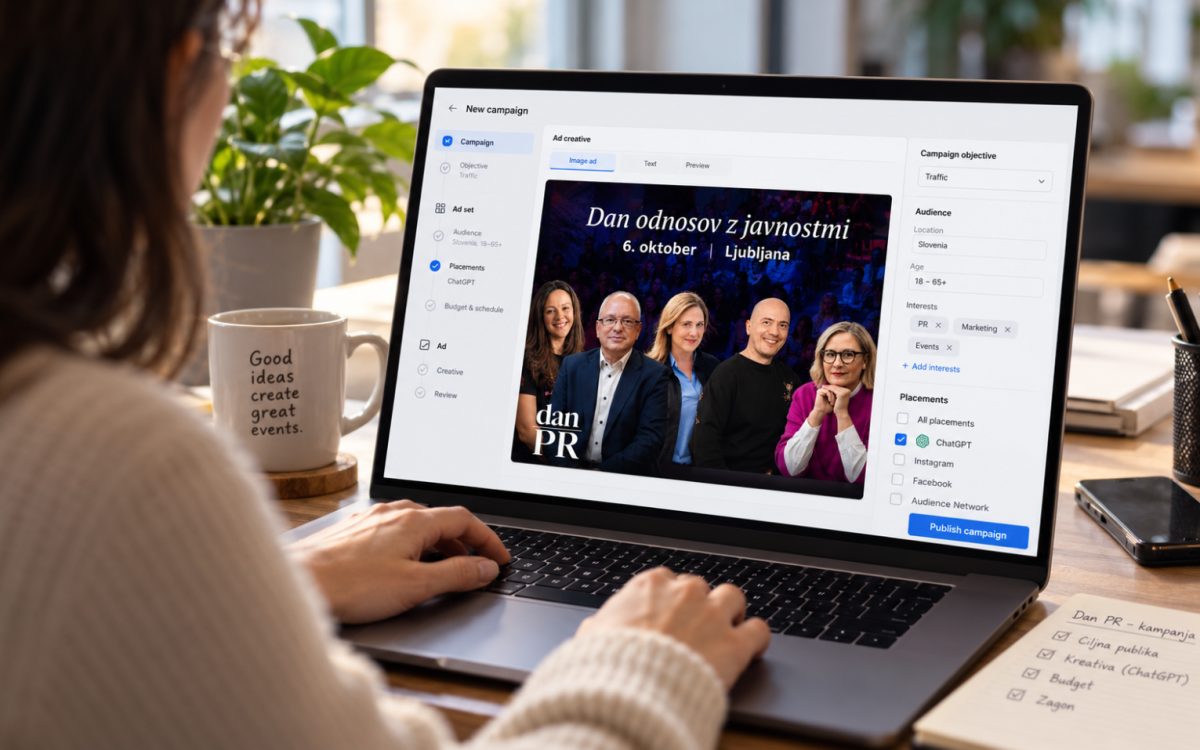
AIOb promociji jutrišnjega Dneva PR smo prvič preizkusili tudi oglaševanje v ChatGPT-ju. Izkazalo se je, da je priprava oglasa pravzaprav najlažji del.
03nov
torek, 03. novembra, 2026
torek, 03. novembra, 2026
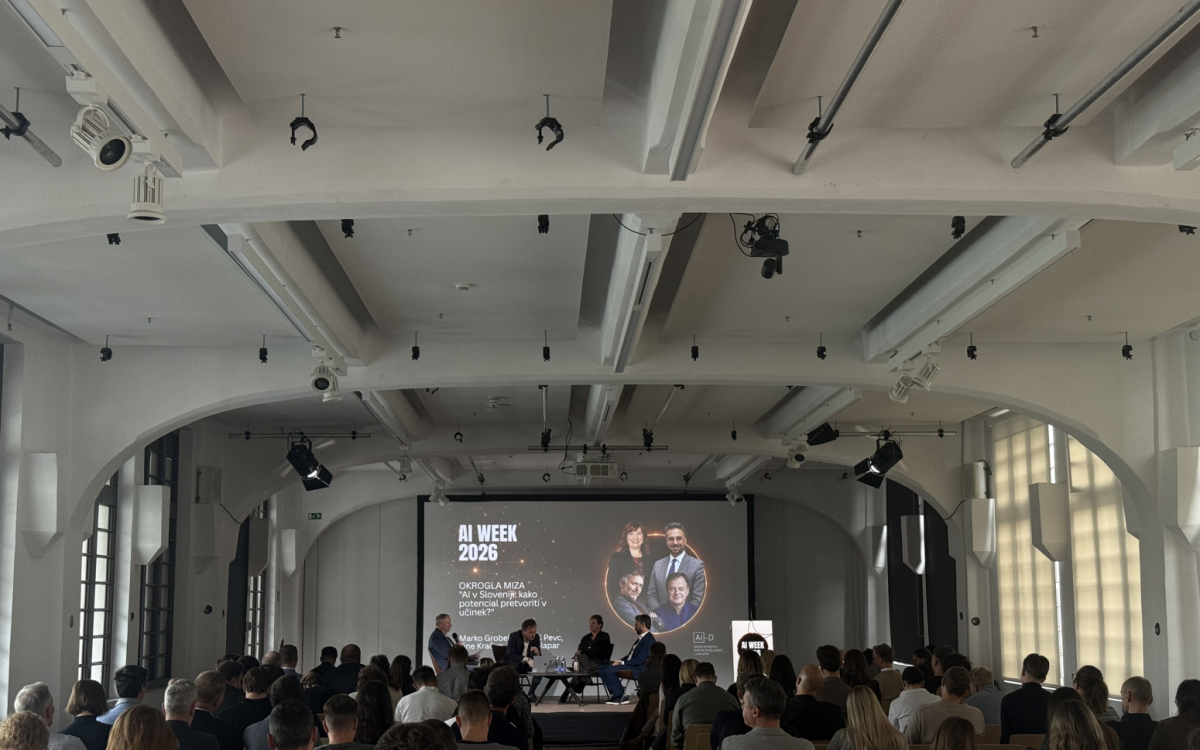
AISloveniji ne manjka znanja o umetni inteligenci, a njeno uvajanje v prakso še vedno spremljajo številne ovire. O njih so razpravljali na današnjem AI WEEK-u v organizaciji Zavoda AI-D.
26okt
ponedeljek, 26. oktobra, 2026
ponedeljek, 26. oktobra, 2026
AIPri Marketing magazinu 24. novembra pripravljamo delavnico z Domnom Danom Gaimanom o vključevanju agentov UI v vsakodnevno delo marketinških ekip.
21okt
sreda, 21. oktobra, 2026
sreda, 21. oktobra, 2026
AIPublicis je v tretjem četrtletju organsko zrasel za 5 odstotkov; trije največji holdingi so v prvem polletju dobili 91 odstotkov velikih medijskih razpisov. Manjše agencije tekmujejo z odzivnostjo.
19okt
ponedeljek, 19. oktobra, 2026
ponedeljek, 19. oktobra, 2026
AIPublicis želi z avtomatizacijo ročnih in ponavljajočih se opravil izboljšati učinkovitost zaposlenih. Skupina poudarja, da se cilj nanaša na opravila, ne na zmanjšanje števila zaposlenih.
13okt
torek, 13. oktobra, 2026
torek, 13. oktobra, 2026
FinanceRevolut je v letu 2025 za oglaševanje in marketing namenil skoraj 626 milijonov evrov. Ob širitvi mednarodnih partnerstev načrtuje tudi odprtje podružnice na Hrvaškem.
08okt
četrtek, 08. oktobra, 2026
četrtek, 08. oktobra, 2026
JobPred trinajstimi leti sta raziskovalca z Oxforda ocenila, kateri poklici so najmanj izpostavljeni avtomatizaciji. Kako na njune napovedi gledaMMo danes?

Če človek zadnje čase bere o slovenski oglaševalski industriji, lahko hitro dobi občutek, da je vse skupaj ena velika »depra«. Nimamo jajc. Nismo dovolj kreativni.

Zakaj samo? Ker smo mnogi od nas v njej videli veliko več kot to.
»Pred menoj stoji študent in predstavlja marketinški načrt. Predstavitev je odlična. Morda celo malo predobra,« v koluMMni razmišlja Doc. dr. Tanja Rihtaršič, vodja poslovnega razvoja na GEA College.
16okt
petek, 16. oktobra, 2026
petek, 16. oktobra, 2026
MMarketingOb selitvi sedeža OTP banke v Ljubljano je NLB konkurenco pričakal z bankomatom, ki je delil sporočila dobrodošlice. Dve leti pozneje pa je oglaševalski dvoboj pred Ljubljanskim maratonom začel OTP.
16okt
petek, 16. oktobra, 2026
petek, 16. oktobra, 2026
OzaveščaMMoPri Jezeršek gostinstvu odgovornosti niso začeli graditi zato, ker je trajnost postala dobra marketinška zgodba.
12okt
ponedeljek, 12. oktobra, 2026
ponedeljek, 12. oktobra, 2026
AktualnoV rubriki Življenje z znaMMkami tokrat gostimo Marušo Komac, vodjo marketinga v Nomagu, in Andrejo Keš, direktorico agencije Bid Bid.